 ▾
なぜAIは幻覚を見てしまうのか? 言語モデルの舞台裏に迫る
AIはわずか数秒でほぼすべての質問に答えることができます。しかし時には、自信満々に真実でない情報を提供することもあります。なぜそれが起こるのでしょうか?そしてAIの「幻覚」とは何なのでしょうか?この記事では、大規模な言語モデルがどのように機能し、なぜ時折不正確な回答を生成するのか、そして開発者がどのようにしてこの問題を徐々に解決しようとしているのかを説明します。
今日の人工知能は、かつては純粋なSFと思われていたことを実現しつつあります。テキストを書き、プログラミングコードを設計し、多くの複雑なタスクについてアドバイスしています。しかし、その回答が滑らかで説得力があるほど、AIが見事にはっきりとした偽の回答を生成するという大きなリスクを忘れがちです。
この現象は「AIの幻覚」と呼ばれています。それは単なる偶然のソフトウェアエラーや開発者が故意に無視した機能ではありません。現代の大規模な言語モデル(LLM)が考え出されてトレーニングされた方法から生じる自然で深く根付いた結果です。これらのシステムがどのように動作するかを理解するために、その仕組みを探ってみましょう。
AIの幻覚とは何か?
生成的人工知能において、幻覚とは文法的にもスタイリスティックにも完璧で信頼できるように見えるが、現実の世界には一切の根拠がない回答をモデルが生成する状況を指します。
モデルは驚くべき方法で幻覚を起こすことができます。存在しない法律の条文を考えたり、数学的な計算でミスをしたり、非常に現実的な科学的研究を具体的な著者名やウェブアドレスと共に生成したりしますが、それらは一度も存在しなかったものです。奇妙なことに、これは著名人の生年月日を確認する場合やアーカイブの人口の公式な歴史的な数字を照会するような些細な質問でも起こることがあります。
言語モデル内で何が起こっているのか?
これらのエラーがどのように発生するのかを理解するためには、次の一つの事実を明確にする必要があります。大規模なチャットボット、例えばChatGPTやGeminiは、インターネットの検索エンジンのように機能しておらず、事実の巨大なデータベースでもありません。彼らは我々の世界に関する実際の知識を持っておらず、真実と偽りを全く区別できません。
言語モデルは基本的には巨大なニューラルネットワークであり、これは基本的には「トレーニングされた直感」の複雑なセットです。これらの直感は、インターネット、書籍、ディスカッションからの何十億もの単語の分析によって取得されました。この非常に財政的かつ技術的に特異なトレーニングの目的は、テキストの意味を理解するためではなく、単に人間の言語を素晴らしくスムーズに模倣することを学ぶことです。
AIはどのようにトークンを扱うか?
チャットボットに質問を書き込むと、ニューラルネットワークは直接的にその言葉とやり取りしません。テキストはまずトークンと呼ばれる部分に分解されます。トークンは予め準備された単語やその一部であり、特定の番号に対応しています。コンピュータ内部の数学的なネットワークは基本的に数字しか扱えません。
モデルはこれらの番号(あなたの質問と会話の全ての以前のコンテキスト)を取得し、それを自らの層を通過させます。しかし、その結果として「正しい答え」を探す引き出しを引き出すことはありません。出力は純粋に数学的な予測です:モデルは、すでに書かれたテキストの次に続く可能性が最も高いトークンを計算します。
モデルが予測する理由
人工知能の動作原則全体は、真実を検証するのではなく確率を推定することに基づいています。モデルはテキストを単語ごと(トークンごと)に組み立てます。新しく生成された各単語は即座に入力に組み込まれ、その新鮮なコンテキストに基づいて次の単語の確率が計算されます。
出力が完全に退屈にならないように、生成中には「温度」と呼ばれる隠れたパラメータが使われます。温度がゼロだと、モデルは常に最も予測可能なトークンを選び、平凡でずっと同じ回答を導きます。より高い温度は、モデルが確率の低い単語にも手を伸ばす可能性を与えます。これにより創造性や興味深いストーリーを書く能力が解放されますが、その一方でモデルが完全な捏造に陥る可能性も劇的に増えます。
どのように一つの答えが段階を踏んで作られるのか?
質問を入力してから最終的な幻覚に至るまでのプロセスは、実際には次のように進みます:
- 入力の分析: あなたの質問は数字(トークン)に変換されます。
- 確率の計算: モデルはコンテキストを考慮し、数百の可能な候補から、統計的に最も適した次の単語を選びます。
- テキストの構築: モデルがデータを欠いているトピックに遭遇する時、知識を持たないふりをせず、流暢な言語を用いて、論理的に見えるが詳細は統計的に推測して構築していきます。
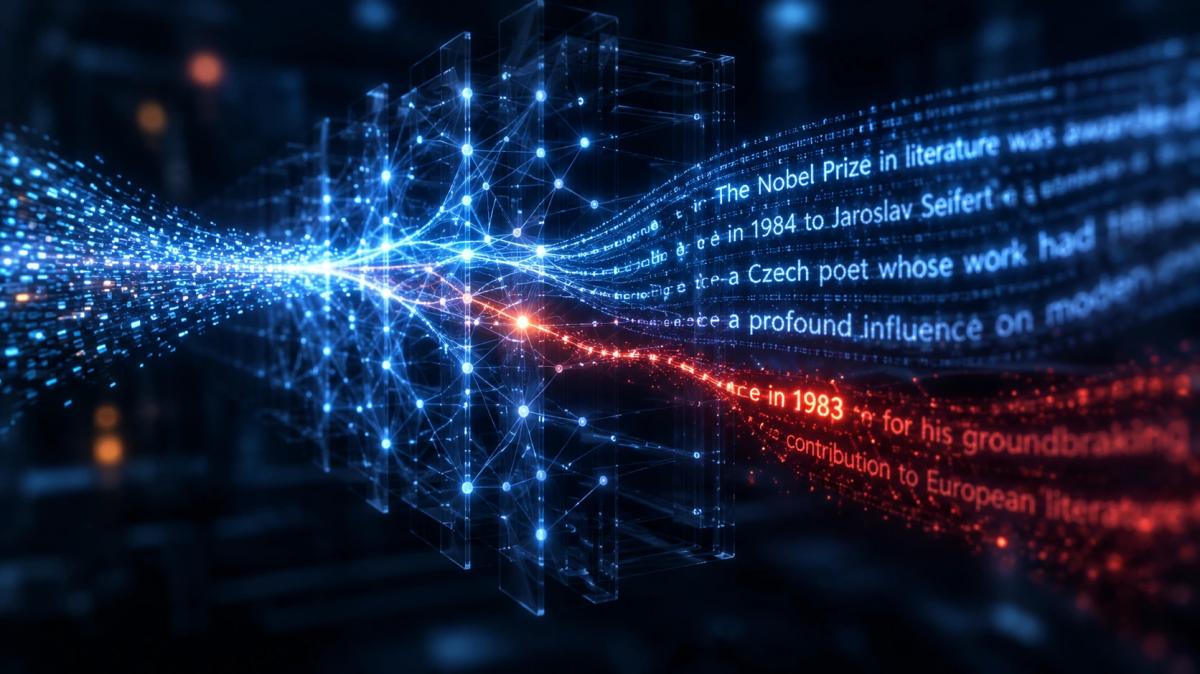
- コンテキストのループ: モデルが文章の途中で誤った詳細を生成すると(例えば、不正解な年や架空の名前)、この詳細がコンテキストに組み込まれてしまい、その後のステップでモデルは自身の虚偽に基づいてさらに信憑性のある説明を追加していきます。
特定の質問は幻覚を引き起こしやすい
トレーニング中(いわゆる事前トレーニング)、モデルは正しい流暢なテキストしか見ません。しかし、データにはさまざまな種類の情報があります。つづりの規則や括弧の正しい閉じ方はテキスト内で何度も繰り返されるため、AIはこれらを完璧に学習します。
問題は、データ内でまれにしか現れず再現性のないパターンを持つ特定の事実です。典型的には正確な数字、歴年、誕生データ、あまり知られていない歴史的出来事です。これらの事実はデータ内で事実上ランダムに見えるため、モデルはそれらを信頼性を持って推論することができません。したがって、もし人工知能に具体的な数値的な情報や詳細を尋ねると、アーカイブからの正確な記憶が必要な場合、幻覚のリスクが急激に上昇します。
AIモデルはどのようにして幻覚を抑えようとしているのか?
現在、開発者はモデルの野生の想像力を抑えるために、いくつかの主要な戦略を使用しています:
- 外部ツールと検索。 数学的計算のためにモデルに電卓が提供されたように、回答の前にウェブを検索する機会が今やあります。関連するページを読み、引用します。これにより答えが捏造される可能性が大幅に減少しますが、引用を伴っても幻覚はまだ発生する可能性があります。
- 思考モデル(Reasoning)。 高度なシステム(例:OpenAIのO3またはO5シリーズ)は、回答を生成する前に内部独白を行います。最初に手順を考え、情報源を確認し、それからテキストをユーザーに送信します。ここでは幻覚の数はかなり少ないですが、現れる場合にはさらに巧妙で発見が難しいです。
- RAGアーキテクチャ(情報検索強化生成)。 主に企業で使用される。モデルは自由な推測から切り離され、内部文書のデータベースを使用してのみ作業するように強制されます。これによりエラーの確率は最小限に圧縮されます。
主な問題は、モデルがテストで評価される方法にあります。ほとんどの順位表は、純粋な成功率(正確さ)を1(正解)または0(誤り)の尺度で測定します。慎重な「わからない」という認識は、常にゼロのスコアになりますが、リスクを冒した推測はモデルに時々得点をもたらす可能性があります。このシステムは、AIがあいまいさを認めるよりも自信を持って推測するように奨励します。そのため、OpenAIは情報を捏造した場合にモデルがペナルティを受け、逆にあいまいさを開示した場合に得点される新しい評価方法を推進しています。
AIからより信頼性のある回答を得るには?
評価システムが変更されるまでは、ユーザーとしてチャットボットの出力を批判的に取り扱う必要があります。リスクを排除するためのいくつかのヒントを以下に示します:
- プロンプトにデータを直接提供せよ。 AIがテキストや法律を分析するよう指示する場合、直接その入力に導入し、そのテキストにないものを追加しないよう厳命してください。これにより作り話の可能性が最小になります。
- 質問のトーンを変えろ。 モデルが論理的に推測できない事を求める質問(正確な統計的数字、伝記の詳細)にモデルを追い込まないようにしましょう。
- 重要なことはすべて確認しろ。 特に法律、医療、金融のような敏感な分野では、AIの出力を独立した、信頼できる情報源でチェックする必要のある粗製のための下書きとしてのみ扱ってください。
よくある質問
AIがメールを送信することや後でタスクを完了することを約束することがありますが、なぜなのか?
モデルは自らの現実的な技術的な能力や現在の時間について何も知らないのです。単に統計的な可能性に基づいてテキストを補完します。タスクを書き込むと、丁寧な確認が文章の最自然な続きとして評価され、背景で何のプロセスも走っていないのにすでに作業中であるかのように表示されます。
チャットボットは完全に架空の本や、実在するように見える科学的記事を作成できますか?
はい、これは非常に頻繁にあります。AIはテキストから学んだ学術的な引用の構造を学んでおり、非常に現実的で専門的な名前を生成することができます。しかし、そうした引用の情報は完全に捏造であり、それを確認する唯一の方法はその特定の作品を独立して検索することです。
同じ質問を新しいチャットで再び尋ねることで、幻覚に対抗することはできますか?
はい、新しいチャットを開くことは非常に効果的な助けです。これによりこれまでの会話のコンテキスト全体が消去されるので、AIが前の文章で間違いを犯した場合は、その性質のために発展し続けるでしょうが、新しいウィンドウでは、確率計算がゼロから始まります。
インターネットでの検索をオンにすると、エラーなしの回答が保証されますか?
残念ながら保証されていません。検索エンジンはモデルに正しいデータを提供しますが、AIはまだ次の単語を推測してテキストを構築します。テストでは、チャットボットはウェブへのアクセスを持っていても情報を誤解し、関連を混乱させ、誤りを含むことができ、その誤りを現実のリンクと交えてしまうことを示しています。
AIを利用する意義はあるのでしょうか、特にこうした間違いがあると知っている場合は?
確かにありますが、期待を変える必要があります。ブレインストーミング、メールの作成、クリエイティブなコンセプトを考えること、または非伝統的な関連を探すなどにおいて、このモデルの自由度は巨大な利点です。しかし、エディターとして行動し、AIに書かせ、事実の詳細を常に自分で確認する必要があります。
CDNとは何か、インターネットコンテンツが世界中にコピーされる理由
読み込まれるビデオ、写真、またはウェブページの背後には、CDNという技術があります。ストリーミングサービス、ソーシャルネットワーク、一般のウェブサイトでも利用されていますが、多くの人はその存在を知らないことが多いです。この記事では、この略語の意味、仕組み、インターネットコンテンツが世界中のさまざまな場所に保存される理由、そしてそれなしでは現代のインターネットがどれほど困難になるかを説明します。
誰があなたの写真、メール、アカウントを相続する?デジタル遺産はほとんどの人が解決していない
遺産について話すとき、多くの人が思い浮かべるのは家、車、銀行口座のお金です。しかし、私たちは何千もの写真、メール、ソーシャルメディアアカウント、またはクラウドに保存されたデータも残しています。それらは死後どうなるのか、誰がアクセスできるのか?この記事では、デジタル遺産の機能、なぜ遺族がデータと問題を抱えるのか、そしてオンラインの足跡を今すぐ整理する方法を見ていきます。
インターネットはどこを実際に流れている?髪の毛のように細い光ファイバーが大陸を繋ぐ
インターネットが主に空気中を流れているという考え方は神話です。テクノロジーの世界全体は、海底の砂の中にある重いハードウェアに依存しています。この記事では、海底ケーブルの技術について詳しく説明します。光ファイバーがどのように機能し、船からの設置に何が伴うのか、そして海の深みがどのようにして地政学的な戦場になったのかをご紹介します。
なぜサブスクリプション疲れに悩まされるのか、そしてお金の流出を4つのステップで止める方法
オンラインサービスに毎月どれくらいのお金を支払っていますか?継続課金システムはしばしば人々を疲弊させます。財布からなくなる小額の支払いが積み重なり、意外にも高額になるのです。2026年の最新データをもとに、私たちの推測と現実の大きな差を示し、支出を少しでもコントロールするための具体的な4つのステップをご紹介します。
弱いWi-Fi?コンセントでのインターネット接続が安定性と穴あけ不要をサポート
階上や寝室にWi-Fiが届かない「デッドゾーン」があり、壁に穴を開けるのは避けたいですか?既に壁内にある電気配線を使って電力線を介してインターネットを転送する方法を見つけてください。この記事では、最新のパワーラインアダプタの仕組みを説明し、4Kストリーミングやゲームを問題なくサポートできる理由、古いアルミ配線に注意すべき点もお伝えします。
なぜビデオが遅れるのか、インターネットスピードが速くても?メガビットがすべてではない
自宅で高速インターネットを利用していても、YouTubeの動画やNetflixでのドラマが絶えず一時停止してしまうことはありませんか?高速インターネットは基礎ですが、スムーズにビデオを視聴するためにはそれだけでは足りないことが多いです。その原因は空のキャッシュメモリであり、デバイスにデータを供給しきれないことがよくあります。ネットワークの弱点を見つけ、理論がうまく機能しない場合の対処法についてご紹介します。